仮想マシン環境でNVIDIAグラフィックデバイスを使用する際に発生していた深刻な性能低下と遅延の問題を根本的に解決する新しい技術が登場しました。従来の仮想化方式では、API呼び出しを仮想マシン内で一つずつ翻訳・シリアライズする過程で膨大な計算リソースを浪費しがちでした。しかし、今回開発された仮想デバイスドライバ方式により、複雑な変換過程を経由せずにカーネルレベルの入出力コマンドを直接転送できるようになりました。実際にゲームやリアルタイム映像ストリーミング環境でテストした結果、通常のPCで動作させた場合と比較しても遜色ない驚くべき処理速度を示しました。特にヘッドレスストリーミング環境を構築しようとする開発者にとって、この技術は渇いた大地に降る恵みの雨のような朗報です。今後、仮想化サーバーを構築する際にグラフィックアクセラレーション性能を最大限に引き出したい場合は、この革新的な技術の動作原理を必ず確認する必要があります。
=
Virtio-技術で仮想マシンにおいてネイティブレベルのNVIDIA GPUを活用する
1. サブタイトル
従来の仮想化グラフィック技術が持つ構造的な限界と問題点
仮想マシン内で高性能グラフィックカードを利用する際に最大の足かせとなるのは、不要なコマンドのシリアライズ過程です。例えば、一般的な仮想化デバイスは、アプリケーションから送信された数千個のグラフィックコマンドをすべて傍受し、仮想マシンの境界を越える翻訳作業を行います。この過程で、全体の計算予算の相当部分が、コマンドの包装・解凍や再実行だけに浪費される非効率が発生します。画面描画サイクルがわずか数ミリ秒に過ぎない高速環境では、こうしたシリアライズ遅延だけでも全体の性能が目に見えて低下します。さらに、仮想マシン内の複雑なコンポジターがホストコンピュータの実際のバッファメモリを直接参照できないという構造的な欠点も存在します。結局、画面に表示された映像を圧縮して外部に送信するため、毎回不要なメモリコピー過程を経なければならず、CPU負荷が急上昇します。IntelやAMDのグラフィックデバイスについてはMesaドライバを通じてある程度の解決策が用意されていましたが、NVIDIA環境では適切な代替手段がありませんでした。
従来の伝統的なパススルー方式は、グラフィックデバイス全体を一つの仮想マシンに丸ごと割り当てるため、リソース活用という点で致命的な弱点があります。複数のユーザーが同時に一つのハードウェアを共有するマルチテナント環境では、こうした丸ごと割り当てる方式がビジネス効率を大きく低下させます。しかし、従来の仮想化グラフィックAPI変換方式を使用すると、最新のゲームや高性能レンダリングアプリケーションが要求する膨大な量のコマンドに対応するのが困難でした。結局、開発者はアプリケーションレベルのAPIを経由せず、デバイスドライバの実際のABIレベルで通信できる新しい道が必要だという結論に至りました。こうした背景の中で、仮想マシン内の軽量ドライバがホストと直接通信してコマンドを伝達する革新的な構造が考案されました。この方式を導入すれば、不要な翻訳段階を劇的に削減できるため、実際のコンピュータにグラフィックカードを直接挿入した場合と同等の効率を発揮できます。
従来の仮想化グラフィック方式はコマンドのシリアライズとメモリコピーにより性能の浪費が大きく、新しいアプローチによってこれを克服しました。
2. サブタイトル
ドライバレベルの入出力コマンド変換と効率的な実行構造
新しい技術であるvirtio-は、仮想マシン内でNVIDIAユーザーモードライブラリが直接グラフィックコマンドバッファを生成することを許可します。仮想マシン内のカーネルドライバは、標準的なNVIDIAデバイスファイルをそのまま登録し、ユーザーから送信された入出力要求を制御キューを通じてシリアライズします。この際、個々のグラフィック描画呼び出しは、仮想マシンの境界を越えるたびに新たに翻訳されるのではなく、ローカル関数呼び出しのようにスムーズに処理されます。デバイス管理レイヤーは、仮想マシン内のハンドルをホストデバイスのファイルディスクリプタに接続し、パラメータ内のポインタを正確に変換します。共有メモリ領域は正しいキャッシュ属性でマッピングされるため、生バイトデータのみを高速にコピーし、デバイス自体のABI判断には介入しません。このように複雑な変換過程を大幅に省略することで、仮想マシンとホスト間の通信コストを極限まで下げることに成功しました。
画面をレンダリングするリアルタイムループ内では、実際に伝達すべき入出力制御コマンドがほとんど存在しないという独特な構造を持っています。ユーザーモードドライバがすでにマッピングされたホストメモリ空間に直接作業内容を記録する方式でコマンドを提出するためです。したがって、画面を描くたびに発生する個々の提出コストを一切支払うことなく、非常に高速な速度でグラフィック作業を処理できます。逆方向に動作するイベント処理キューは、ホストが開かれたディスクリプタの状態を監視し、グラフィック作業を待っている仮想マシンを適切なタイミングで目覚めさせます。もしこうした目覚めさせる経路が存在しなければ、仮想マシンはデバイスが常に準備完了していると仮定して、意味のないリソースを消費するポーリング現象に陥ります。こうした精緻なイベント管理のおかげで、リソースの浪費を最小限に抑えながらハードウェアの性能を極限まで引き出す基盤が整えられました。
ユーザーモードドライバがホストメモリに直接コマンドを記録することで、不要な通信コストと遅延を排除したことが核心です。
3. サブタイトル
実際のハードウェア環境で測定した性能測定値と詳細な分析
開発チームは、NVIDIA RTX 3060グラフィックカードが搭載された実際のシステム環境で、同じヘッドレスレンダリング負荷を与えながら性能を精密に測定しました。ホストコンピュータのフレーム処理時間が39ミリ秒の場合、仮想マシン内部の速度はむしろ0.4パーセント速く測定され、誤差範囲内の同等の性能を示しました。処理時間が9.9ミリ秒の環境でも0.7パーセント速い数値を記録し、2.0ミリ秒の区間ではわずか1.7パーセントの微細な差しか発生しませんでした。フレーム処理時間が約2ミリ秒以上の一般的な負荷状況では、実際のコンピュータ性能の98パーセントから100パーセントのレベルを完璧に維持しました。ただし、フレーム処理時間が0.5ミリ秒以下に低下する非常に軽い負荷状況では、グラフィックデバイスが待機から目覚めるのにかかるコストが相対的に目立ちました。極めて短い瞬間に作業を終えなければならない極端な軽い負荷では、実際のコンピュータと比較して性能が70パーセントレベルまで低下する現象も観察されました。
フレーム速度に別途制限をかけず、1秒あたり約100フレームの速度で12秒間動作させた場合、CPU使用時間は驚くほど少なかったです。ホストコンピュータが0.40秒を消費する間、仮想マシン内部は0.37秒のみを使用して、むしろ少ないリソースで円滑に動作することを証明しました。全体で80万枚を超えるフレームを処理する間、バックエンドが行き来したメッセージはわずか1万3千個程度に過ぎず、非常に高い通信効率を証明しました。フレームあたり平均して約59回に1回꼴でしか仮想マシンの境界を越えませんでした。それも大半はデバイス設定のための初期作業でした。画面を連続して描き出す実際のレンダリングループ区間では、フレームあたりの境界通過回数はわずか0.02回程度で、事実上仮想化の壁を感じませんでした。これは過去の仮想化方式がフレームあたり数千個のメッセージを行き来しながら苦戦していたものと比較すると、脱胎換骨レベルの発展と言えるでしょう。
約2ミリ秒以上の一般的な負荷環境では、実際のコンピュータと区別がつかないほど完璧な性能維持力を見せます。
4. サブタイトル
ヘッドレスストリーミング環境で発揮される強力なリアルタイムエンコーディング能力
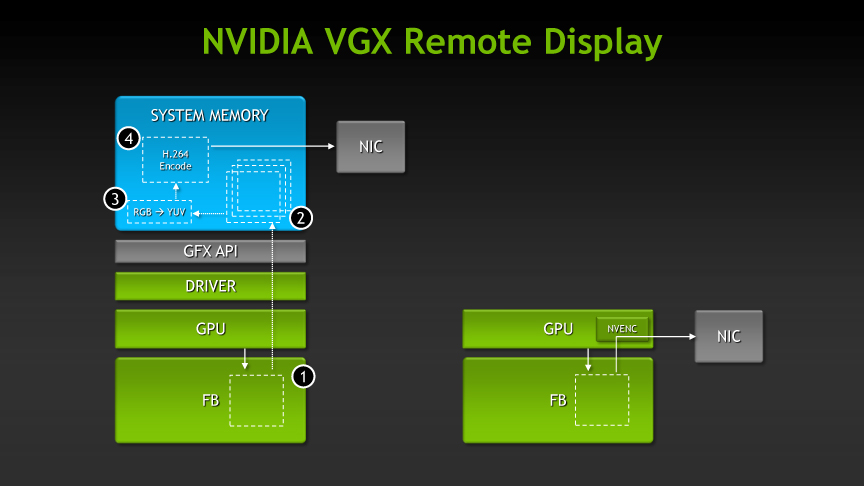
この技術が最終的に狙っている主戦場は、モニターが接続されていないサーバー環境で画面を描画して圧縮送信するヘッドレスストリーミング分野です。クラウドゲームサービスやリモート仮想デスクトップ環境では、画面を高速にレンダリングし圧縮してユーザーの端末にリアルタイムで送信する作業が生命線です。今回開発された方式を活用すれば、仮想マシン内で直接グラフィックをレンダリングし、ウィンドウを合成した後、ハードウェアエンコーダーに直接接続できます。仮想マシン内で生成された圧縮ビットストリームのみを外部に送り出せばよいため、ネットワーク帯域幅を劇的に節約しながらも滑らかな画面を提供します。これを実現するには、バッファハンドルとフェンスだけでなく、デバイスポインタやハードウェアエンコーディングセッションに対する実際のドライバレベルのアクセス権限が完璧に裏付けられていなければなりません。従来の仮想化技術は、こうした複雑なパイプラインを処理する過程で毎回CPUを経由する必要があり、遅延時間が急上昇する問題を抱えていました。
一つの高性能グラフィックデバイス上で複数の仮想マシンが同時にレンダリング作業を実行しながら映像エンコーディングを処理するテストも成功裏に完了しました。一つの物理デバイスで4つの仮想マシンが同時に高画質映像をエンコーディングしていても、全体の処理量は単一の仮想マシンの場合とほぼ差がありませんでした。ハードウェアリソースが各仮想マシンに均等に公平に分配されるため、特定の仮想マシンによってシステム全体が遅くなる現象は発生しませんでした。外部に出るデータはフレームあたりわずか100キロバイト前後の圧縮ビットストリームであるため、会社のネットワーク機器に掛かる負担も非常に少ないです。リモートワーク環境やクラウドベースのリアルタイム協業ツールを運営する企業にとっては、サーバー運営費を大幅に削減できる優れた代替案です。今後、高画質リアルタイムストリーミングサービスを企画する開発者にとって、この仮想化技術は必須のインフラ選択肢となるでしょう。
仮想マシン内でレンダリングとリアルタイムエンコーディングを同時に実行しながら、ネットワーク帯域幅を劇的に削減します。
5. サブタイトル
セキュリティ分離レベルとマルチテナント環境での実務的な活用シナリオ
性能面で飛躍的な発展を遂げましたが、この技術を現場に導入する際に必ず考慮すべき重要なセキュリティ特性が存在します。今回開発された方式は、仮想化技術でよく使われるIOMMU(入出力メモリ管理ユニット)ベースのハードウェアレベルの分離機能を提供しません。つまり、ホストコンピュータにインストールされたNVIDIAドライバを完全に信頼しなければならず、互いに信頼できないマルチテナント環境には適していません。もし複数の顧客の仮想マシンが一つの物理サーバーを共有する公共クラウド環境であれば、従来のデバイス全体割り当て方式を使用する必要があります。一方、社内インフラ構築や信頼できる開発チーム内部の仮想サーバー運営のようにセキュリティ信頼が確保されている場所では、断然最良の選択です。不要なハードウェア分離レイヤーを取り除いたおかげで性能を最大化できたため、使用目的に合った慎重な選択が必要です。
企業のIT担当者の方は、サーバー仮想化戦略を策定する際にこうした技術的特性を正確に理解し、適切な環境に配置する必要があります。例えば、社内デザイナー向けの高性能リモート作業用仮想マシンを構築する際にこの方式を導入すれば、コスト効率と速度の両方を確保できます。高価なグラフィックカードを複数の仮想マシンに柔軟に分配しながらも、ネイティブに準ずる画面の滑らかさを提供するため、ユーザー満足度が大幅に向上します。また、AIモデルの学習や大規模データ分析作業を仮想化環境で処理する場合も、リソース浪費のない効率的な計算が可能になります。今後、仮想化技術の発展方向が徐々にハードウェアの壁を取り払い、性能の限界を克服する方向に向かうことは明確な時代の流れです。こうした変化の波の中で、新しいドライバ変換技術が実務現場にどのような変化をもたらすのか注目する必要があります。
ハードウェア分離機能がなく、信頼できないマルチユーザー環境よりも、単一企業の内部サーバー構築に最も適しています。
6. サブタイトル
仮想化グラフィックの未来展望とシステムエンジニアが取るべき対応戦略
今後、仮想マシン環境でグラフィックデバイスを扱う技術は、ハードウェアとソフトウェアの境界をさらに崩壊させる方向に進化していくでしょう。過去には、仮想化環境で高性能グラフィック作業を実行すること自体が不可能だったか、膨大な性能犠牲を強いられていました。しかし、ドライバレベルの直接通信と最適化されたメモリ共有技術が普及するにつれ、仮想化の概念自体が完全に新たな局面を迎えました。今やシステムエンジニアは、単に仮想マシンを起動するだけでなく、ホストとゲスト間の通信コストを最小化するアーキテクチャを検討する必要があります。不要な翻訳段階を除去し、ドライバの実際の制御権をどれだけ柔軟に確保できるかが、今後のインフラ構築の成功を分ける核心的な基準となります。今回登場した革新的な技術は、今後さらに多くのグラフィックメーカーが仮想化フレンドリーなドライバ構造を検討するよう促す触媒役を果たすでしょう。
読者の皆様も、迫りくる仮想化エコシステムの変化に合わせて、実務システムのグラフィックパイプラインを点検されることをお勧めします。特にリモートストリーミングやクラウドベースのリアルタイムレンダリングサービスを運営している場合は、従来の仮想化方式の限界を直視する必要があります。仮想マシン内でエンコーディングまで一度に処理できる新しいアプローチをテストし、自社システムに適用できるかどうかを探ってみてください。最初は馴染みのない構造に見えますが、実際に性能測定を行えば、なぜこの技術が注目されているのか納得されるでしょう。今後さらに激しくなるクラウドインフラ競争で、他社より一歩先に高性能グラフィック仮想化システムを完成させてみてください。技術の本質を正確に理解し、賢く導入する企業だけが、迫りくるデジタル革新の勝者になれるのです。
ドライバレベルの最適化が仮想化インフラの勢力図を変えているため、新しいアーキテクチャの導入を積極的に検討すべきです。
よくある質問
=